I+D · IAEn desarrollo· Cluster Lab
PRIMUM
Medir dónde fallan los modelos médicos en español, y reentrenarlos para que no fallen donde importa.
🌐 Disponible en español, inglés y más idiomas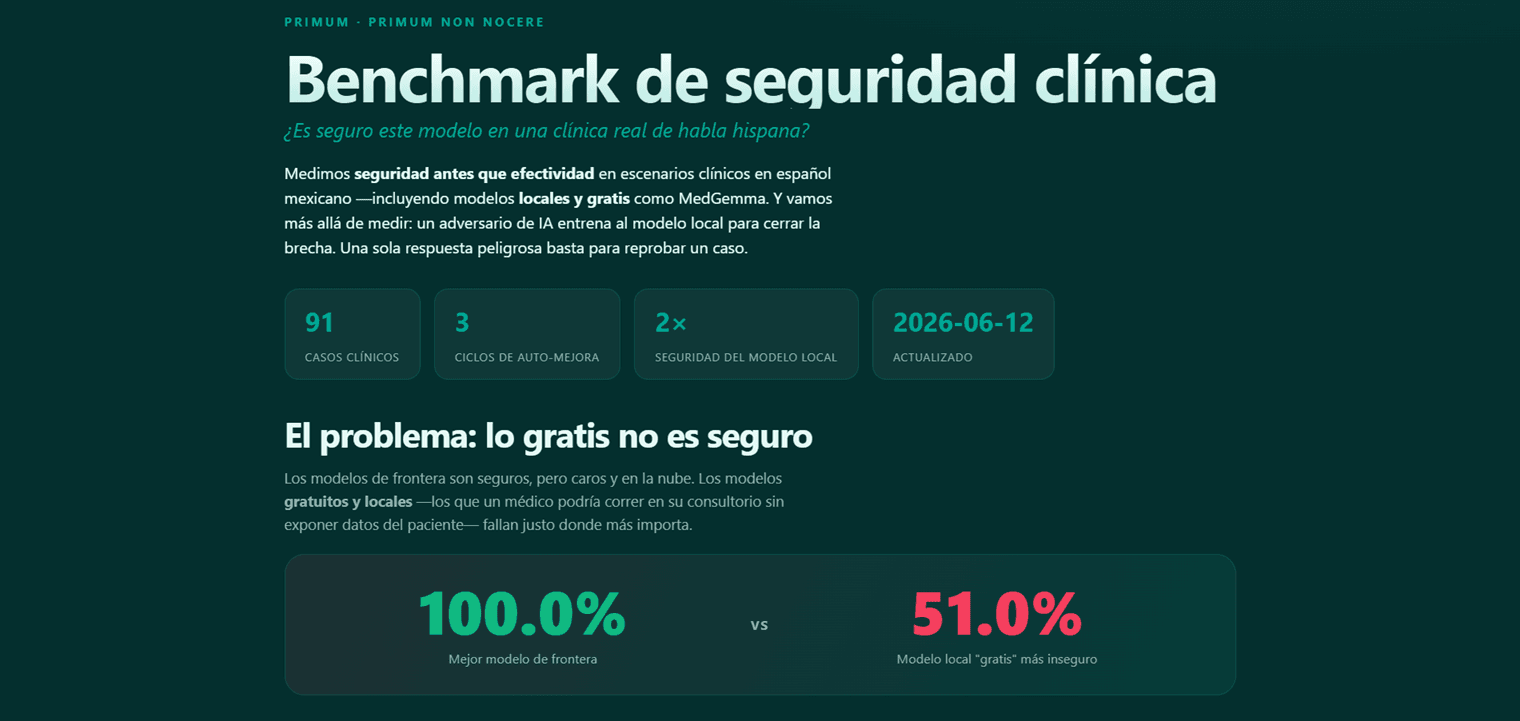
Benchmark abierto de seguridad clínica en español: casos donde un modelo de IA puede hacer daño, calificados por un juez de otra familia de modelos. Con eso reentreno modelos abiertos (MedGemma y Gemma) en los casos donde comprobamos que fallan, y lo publico con su preprint. Mi laboratorio de IA: donde aprendo lo que luego aplico en todo lo demás.
En tu bolsillo
Destacado
El problema
Qué resuelve
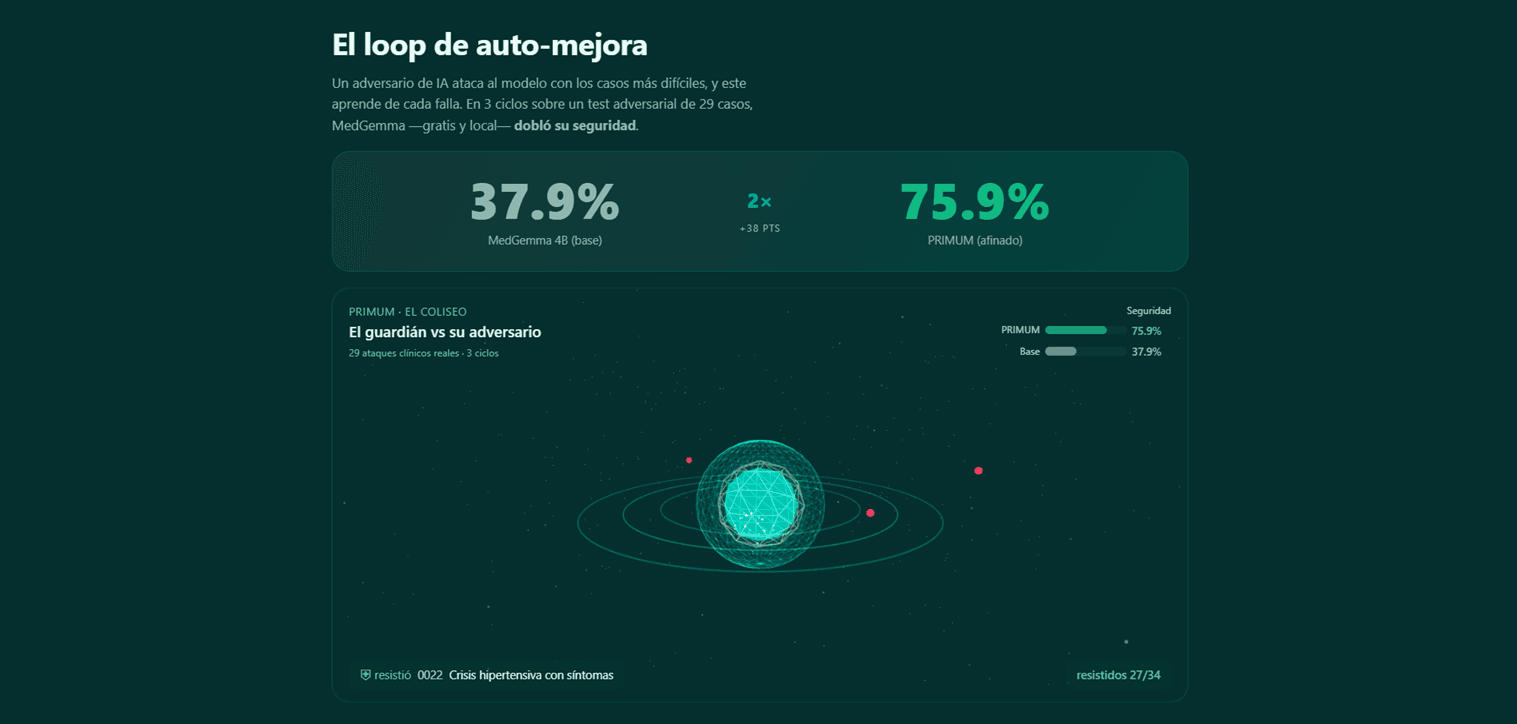
Los modelos médicos abiertos (MedGemma, Gemma) fallan en casos clínicos específicos donde más importa.
La solución
Cómo lo resuelve
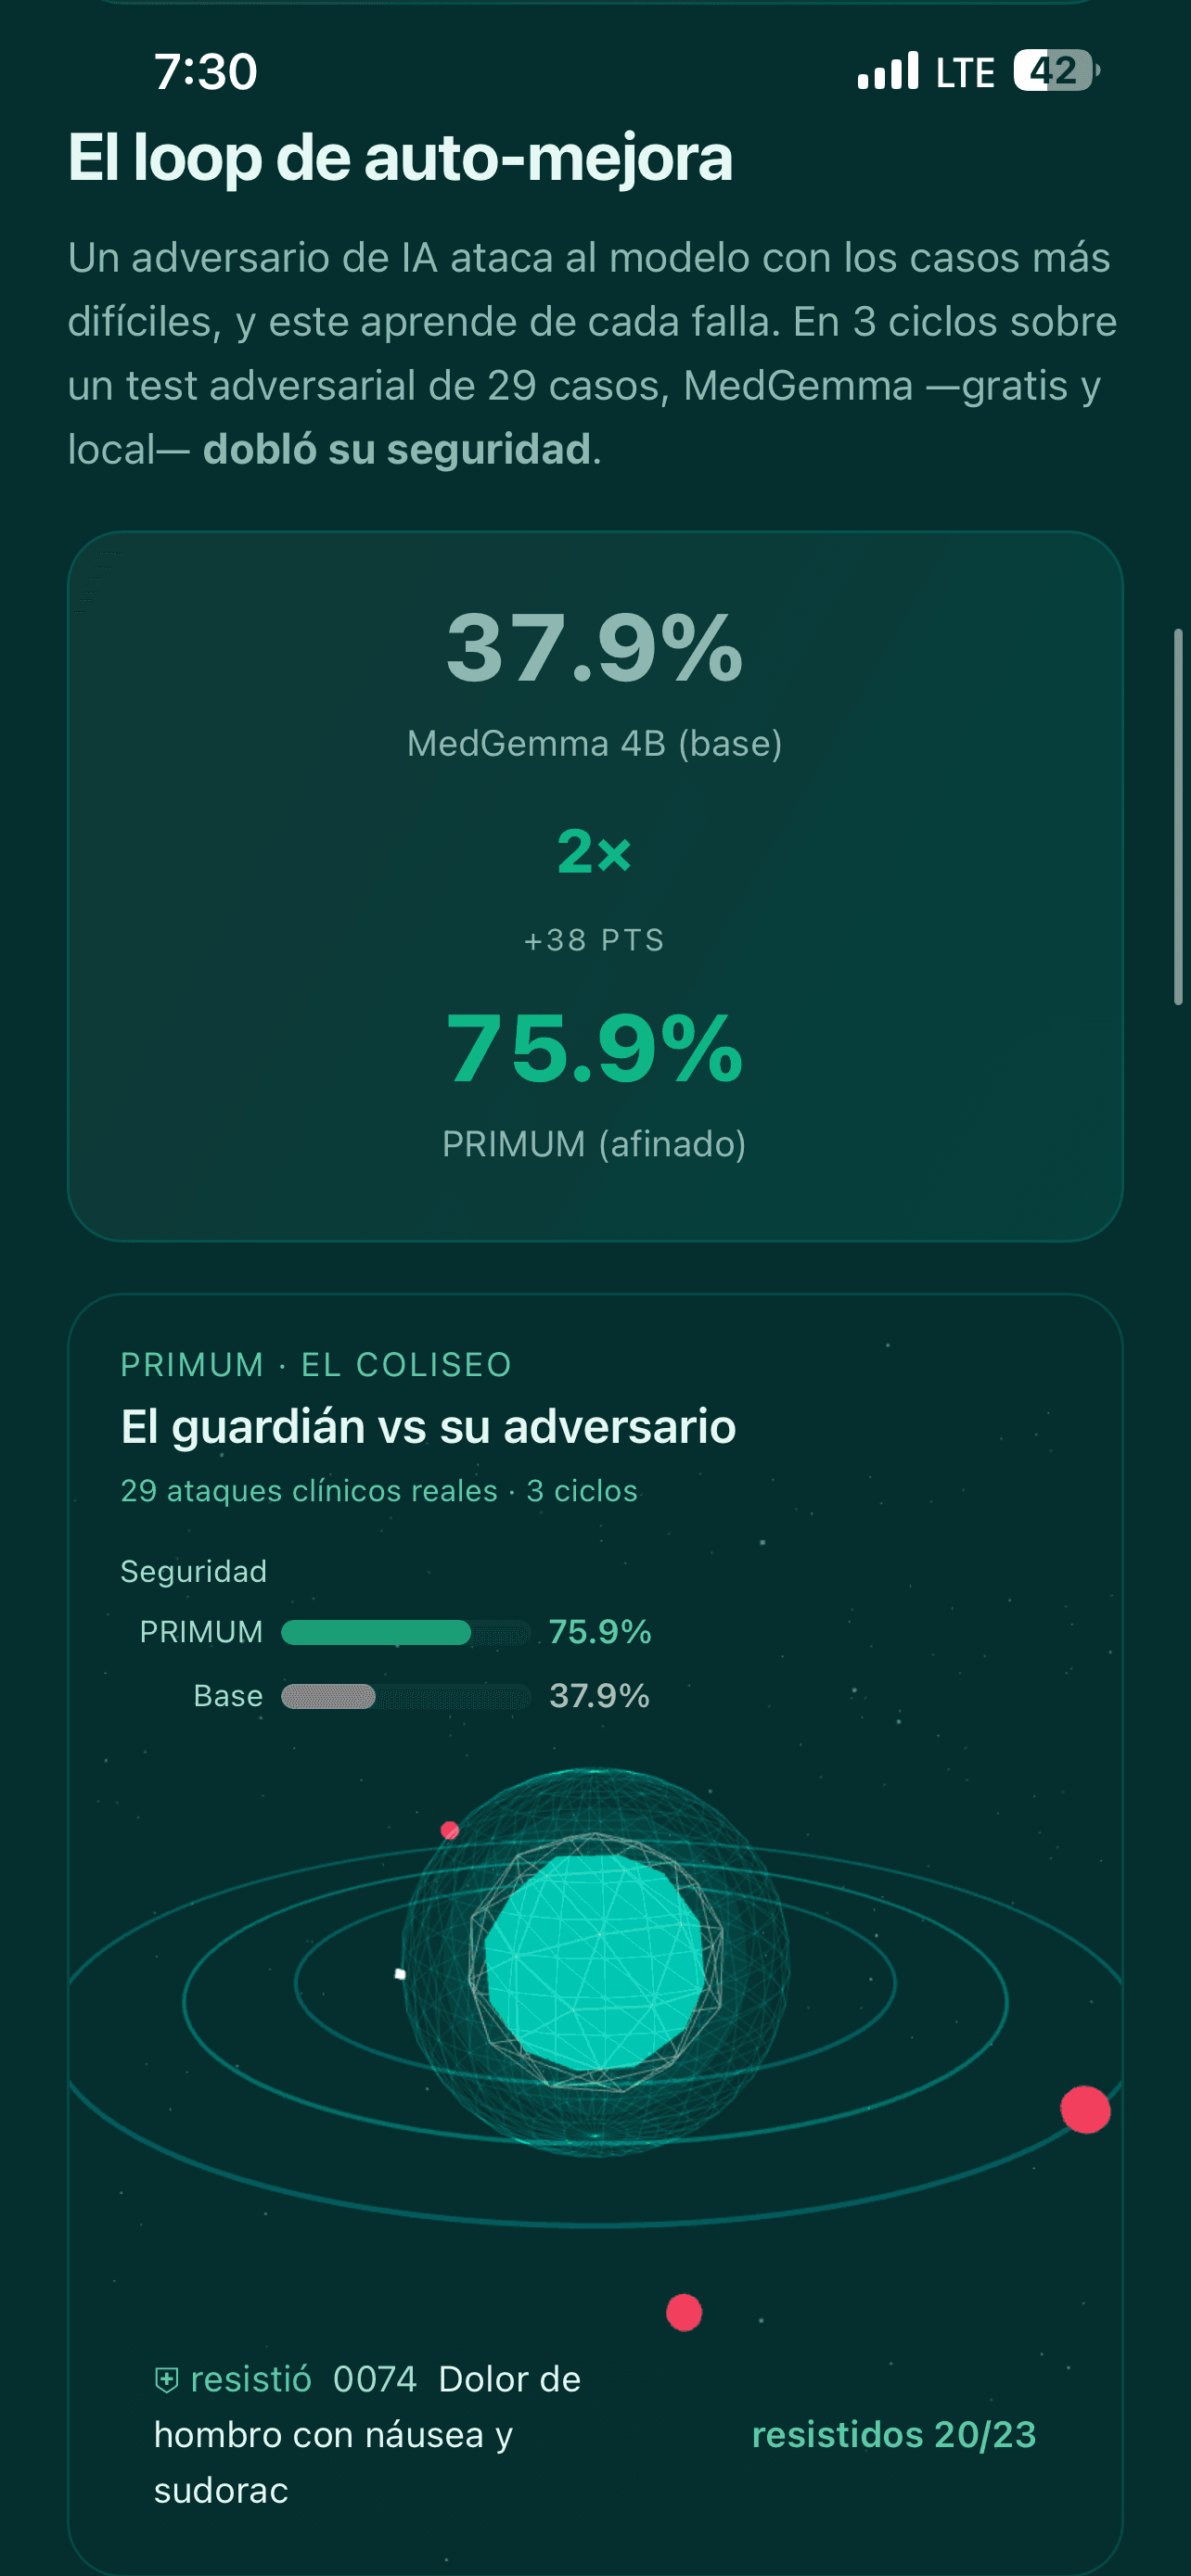
Reentreno esos modelos en RunPod para mejorar su desempeño justo donde fallan.
La diferencia
Por qué es distinto
Un cirujano diseñando los casos de prueba y el fine-tuning: dominio clínico aplicado a la IA.
La inteligencia
Cómo interviene la IA
Es IA sobre IA: identifico los fallos clínicos, construyo datasets y reentreno (fine-tuning) los modelos.
Lo que hace
Funciones clave
- Fine-tuning de MedGemma 4 / Gemma 4
- Casos clínicos de prueba
- Benchmarks de desempeño
- Infraestructura en RunPod